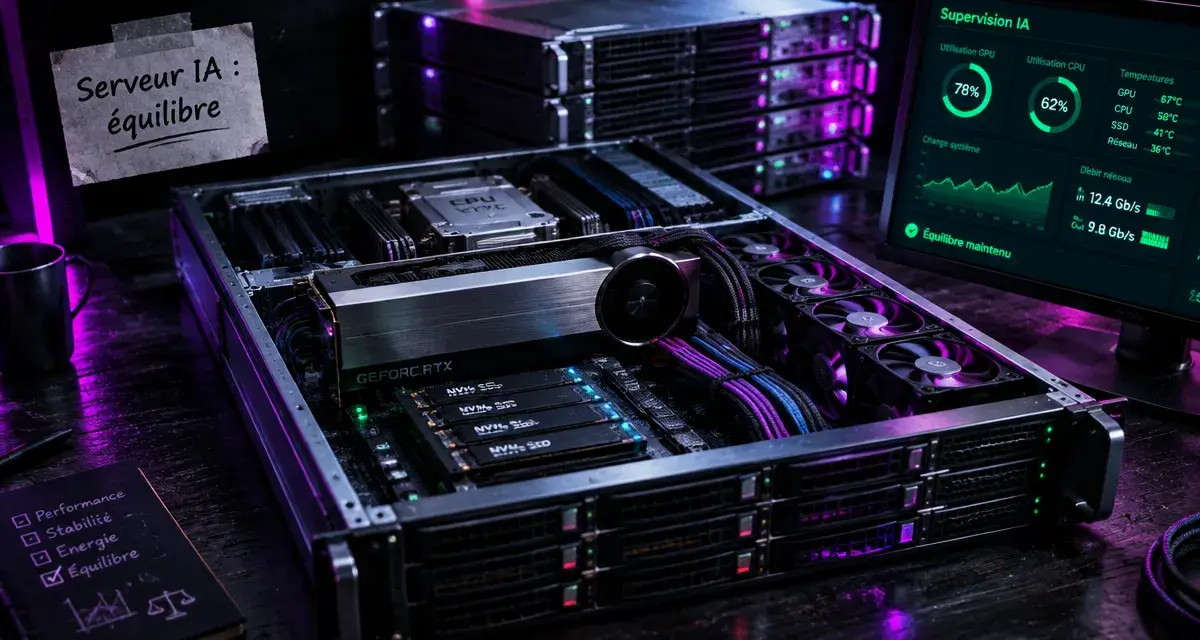
Un serveur pour l’intelligence artificielle est une machine conçue pour entraîner des modèles ou les exécuter en production. Sa performance dépend du calcul, mais aussi de la mémoire, du stockage et du réseau. Avant de choisir une configuration, il faut surtout distinguer deux besoins : apprendre à partir de données et répondre rapidement à des utilisateurs ou à des équipements.
Partir du travail à accomplir, pas du nombre de GPU
Un serveur d’IA associe du matériel et des logiciels adaptés aux charges de machine learning et de deep learning. Contrairement à un serveur généraliste, souvent dimensionné pour des applications métier ou des bases de données, il peut privilégier le traitement parallèle et les échanges rapides entre accélérateurs. Il n’a toutefois pas obligatoirement besoin d’un GPU : certains modèles fonctionnent efficacement sur CPU.
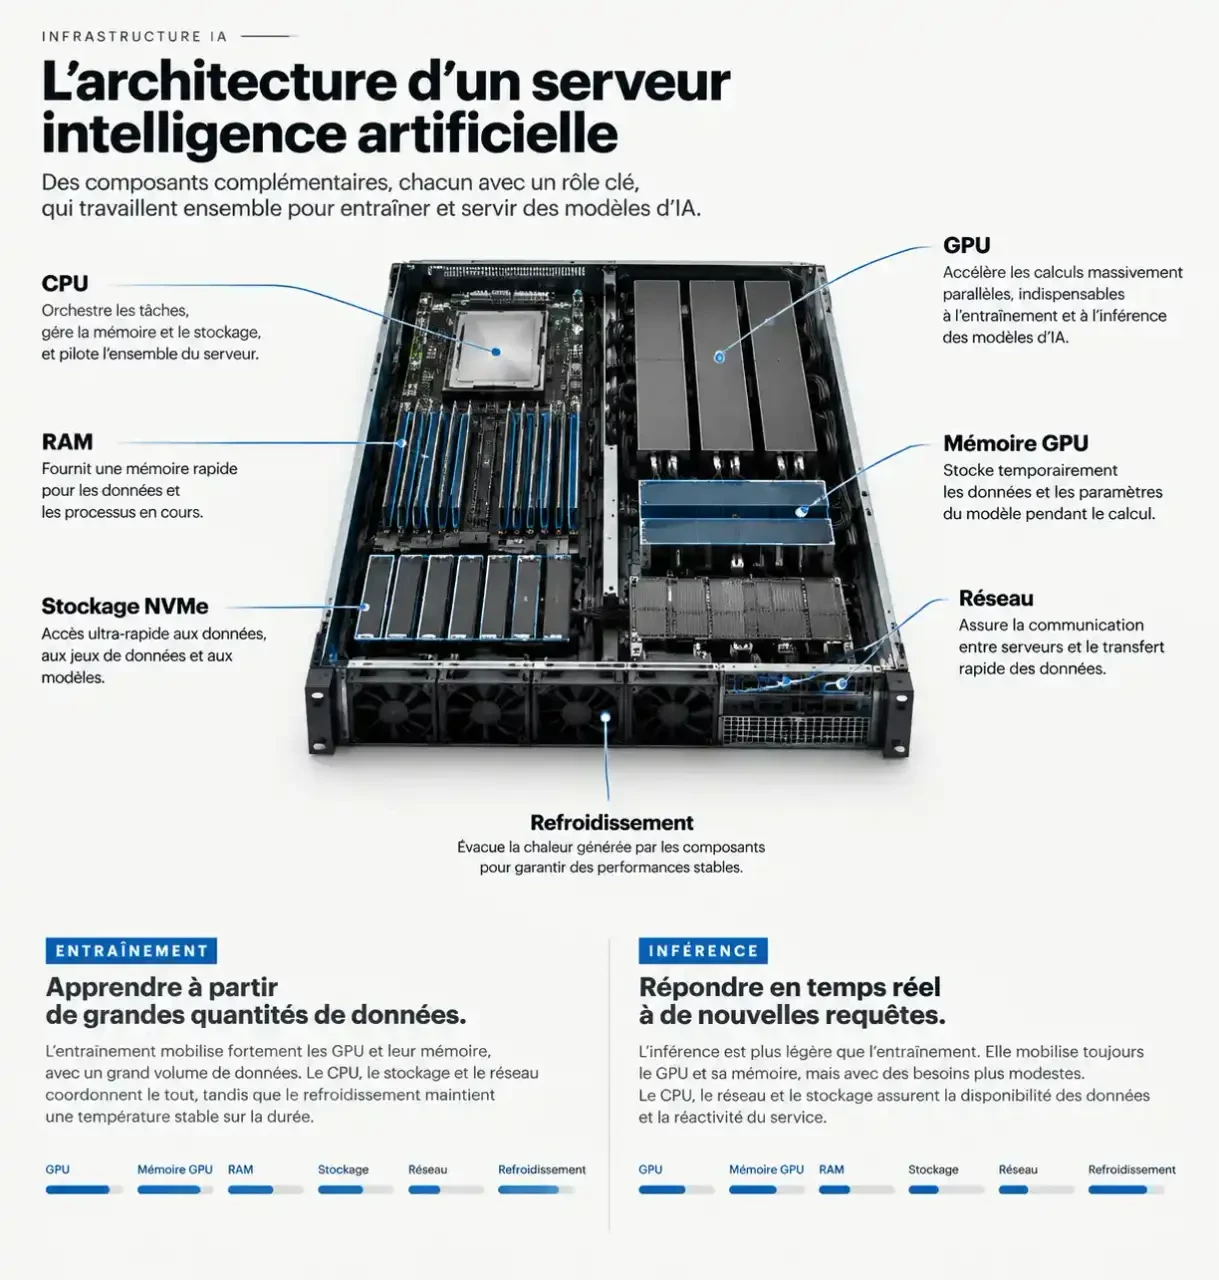
Il se distingue aussi d’un PC avec IA. Ce dernier accélère surtout des fonctions locales pour son utilisateur. Un serveur fournit généralement un service partagé, avec des exigences d’administration à distance, de disponibilité, de contrôle des accès et de montée en charge.
Entraîner, ajuster ou simplement exécuter un modèle
L’entraînement consiste à faire apprendre un modèle à partir de données. L’ajustement, ou fine-tuning, adapte un modèle existant à un domaine particulier. Ces opérations peuvent mobiliser beaucoup de calcul et de mémoire. L’inférence, elle, utilise le modèle pour produire une réponse, classer une image ou détecter une anomalie. Son dimensionnement dépend notamment du nombre de requêtes simultanées et du délai de réponse acceptable.
Dans une chaîne opérationnelle, les données sont collectées, nettoyées puis préparées avant l’apprentissage. Le modèle est ensuite évalué, déployé et surveillé. Un accélérateur puissant ne corrigera ni des données mal préparées ni un déploiement mal conçu.
Traduire un usage métier en contraintes techniques
Un assistant documentaire interne doit gérer des conversations concurrentes et accéder aux documents autorisés. Une ligne industrielle inspectant des images privilégie une latence prévisible. Un système de prévision commerciale peut, lui, traiter des lots pendant la nuit. Ces usages appellent des architectures différentes : le temps de réponse, le débit et la disponibilité ne sont pas interchangeables.
Équilibrer les composants pour éviter les goulets d’étranglement
Le CPU prépare les données, orchestre les tâches et exécute les traitements généralistes. Le GPU réalise de nombreuses opérations en parallèle, ce qui convient particulièrement aux calculs matriciels des réseaux de neurones. Les deux se complètent : un CPU saturé peut laisser un GPU attendre au lieu de calculer.
| Composant | Usage pertinent | Atout | Limite et intégration |
|---|---|---|---|
| CPU | Préparation des données, modèles classiques, certaines inférences | Polyvalence | Moins adapté à certains calculs massivement parallèles ; intégration généralement accessible |
| GPU | Deep learning, entraînement et inférence | Traitement parallèle | Mémoire et consommation à surveiller ; compatibilité logicielle indispensable |
| FPGA | Traitements spécialisés, certains usages edge | Logique reconfigurable | Développement spécialisé, complexité élevée |
| TPU | Calcul tensoriel dans un environnement compatible | Accélération spécialisée | Dépendance à l’écosystème matériel et logiciel |
| ASIC | Tâches ciblées à grande échelle | Efficacité sur une fonction précise | Faible polyvalence ; intégration dépendante du produit |
Mémoire système et mémoire GPU : deux budgets distincts
La RAM héberge les données et les processus côté serveur. La mémoire GPU accueille notamment les paramètres du modèle et les données nécessaires au calcul. Prévoir 64 Go ou plus de RAM peut être pertinent pour certaines charges, mais ce n’est pas une règle universelle. La mémoire GPU nécessaire varie avec le modèle, sa précision numérique, la longueur des entrées et le nombre de requêtes traitées ensemble.
Les chiffres de bande passante doivent également être comparés avec prudence : 50 Go/s et 7,8 To/s ne décrivent pas nécessairement la même liaison ni le même niveau de mémoire. Une valeur isolée ne permet donc pas de classer deux serveurs.
Stockage, interconnexions et refroidissement
Le stockage doit alimenter les calculs sans attente excessive. Des SSD NVMe peuvent accélérer les lectures, tandis qu’un espace distinct conserve les jeux de données, les versions de modèles et les sauvegardes. Dans une architecture distribuée, le réseau et les interconnexions entre GPU deviennent déterminants.
Des configurations de 4 à 8 GPU existent pour les charges importantes, mais elles imposent de vérifier alimentation, encombrement et évacuation thermique. Le refroidissement par air, liquide direct ou immersion relève d’un choix d’infrastructure : ajouter des accélérateurs sans capacité thermique suffisante peut entraîner une réduction automatique de leur fréquence.
Placer le serveur là où les contraintes l’exigent
Le cloud facilite l’expérimentation et l’accès temporaire à des ressources puissantes. Il convient notamment aux besoins variables, sous réserve de vérifier la disponibilité des accélérateurs, les frais de transfert et les conditions de traitement des données. Un serveur dédié réduit la concurrence pour les ressources, sans garantir à lui seul une performance constante.
Sur site, l’entreprise conserve davantage de maîtrise sur son environnement, mais assume l’installation, la maintenance et le renouvellement. Un hébergement en datacenter constitue une autre option pour disposer de ressources dédiées sans exploiter sa propre salle informatique.
L’edge rapproche l’inférence des machines, des caméras ou des capteurs. Il peut limiter les transferts et la dépendance à une connexion distante. En contrepartie, l’équipement doit respecter des contraintes de consommation, de format et parfois de température ou de poussière.
Pensez la frontière entre ces environnements comme une membrane sélective : tout ne doit pas la traverser. Une caméra peut transmettre un résultat de détection plutôt qu’un flux vidéo permanent ; un service central peut recevoir des indicateurs plutôt que les données brutes. Définir ce qui reste local, ce qui circule et ce qui est conservé aide à dimensionner le réseau et à limiter l’exposition des informations sensibles.
Valider une configuration sur des mesures et un coût d’exploitation
Il n’existe pas de configuration universelle pour un serveur d’intelligence artificielle. La bonne méthode consiste à tester une charge représentative avant l’achat ou l’engagement cloud. Un prototype réussi avec un utilisateur ne prouve pas que le service tiendra lors d’un pic de demandes.
- Décrire la charge : modèles utilisés, volumes de données, entraînement ou inférence, simultanéité et horaires d’activité.
- Fixer les objectifs : délai de réponse acceptable, débit attendu, qualité des résultats et disponibilité nécessaire.
- Tester l’ensemble : consommation mémoire, utilisation CPU et GPU, lectures disque, réseau et comportement en charge prolongée.
- Chiffrer l’exploitation : matériel ou location, énergie, refroidissement, licences, stockage, transferts et temps d’administration.
- Préparer l’évolution : capacité mémoire supplémentaire, emplacements disponibles, puissance électrique et compatibilité logicielle.
La sécurité doit faire partie du cahier des charges : segmentation réseau, accès à privilèges limités, chiffrement adapté, mises à jour et sauvegardes testées. Un hébergement local ne suffit pas à assurer la confidentialité ; les accès d’administration et les flux sortants doivent aussi être maîtrisés.
Enfin, demandez ce que couvrent réellement le support et la supervision 24/7. Une alimentation redondante protège contre certaines pannes, pas contre l’indisponibilité de toute la machine. Si le service est critique, il faut prévoir la reprise sur une autre instance. Le bon investissement est celui qui respecte vos objectifs en conditions réelles, avec une exploitation soutenable, plutôt que celui qui affiche le plus de GPU.
- Serveur intelligence artificielle : le GPU ne suffit pas à faire la performance - 6 novembre 2026
- Calendrier de l’Avent jeux de société : 24 surprises à choisir selon votre façon de jouer - 5 novembre 2026
- Peluche à intelligence artificielle : sans écran ne veut pas dire sans risques - 4 novembre 2026
Articles qui pourraient vous intéresser :
 SmartTrack : 28 jours d’autonomie et suivi santé de précision au quotidien
 EmuSAK : Éliminez les saccades sur Ryujinx et automatisez vos shaders en un clic
 Disque dur externe PS5 : 3 gammes de prix pour booster votre stockage sans vous ruiner
 L’intelligence artificielle transforme la mode, de la création au réassort